Address Clustering چیست؟
چرا چند آدرس لزوماً به معنی چند نفر نیست؟
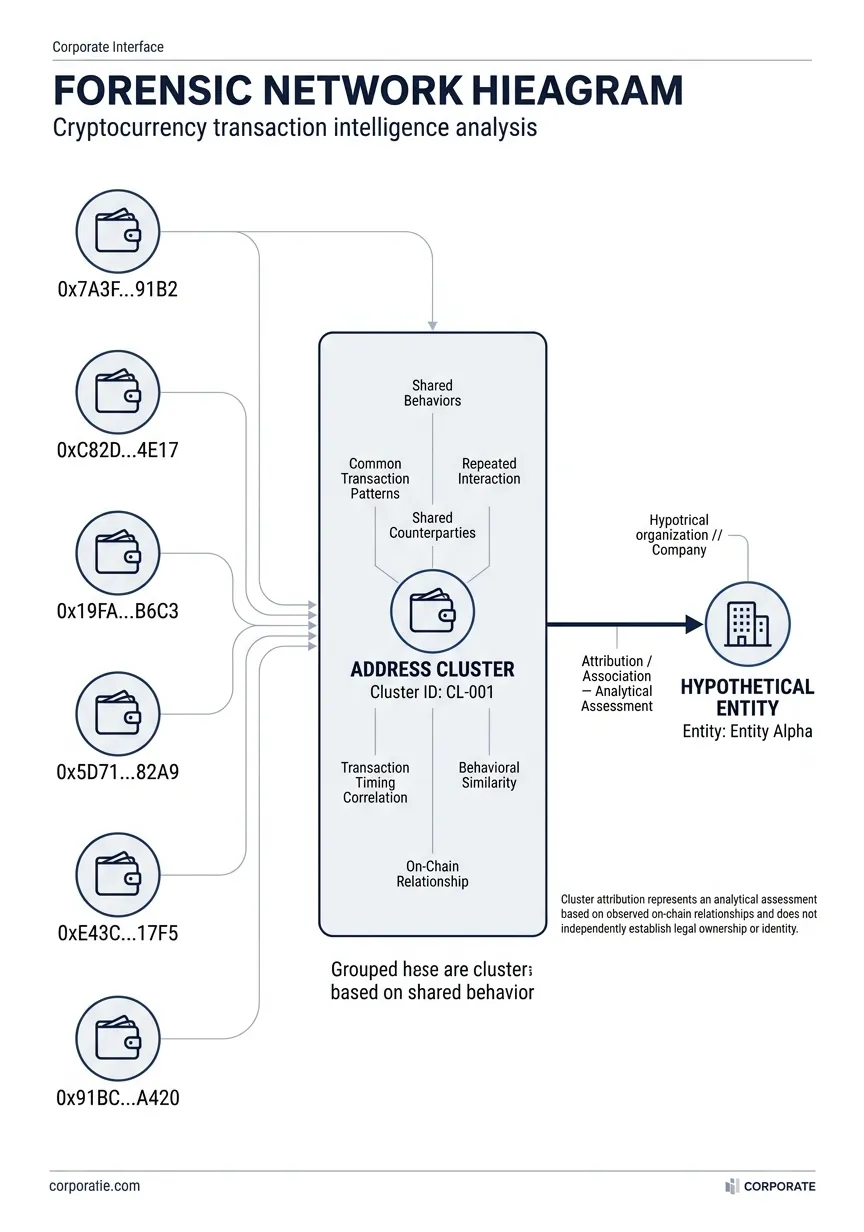
یکی از جذابترین قابلیتهای تحلیل بلاکچین این است که یک آدرس را همیشه بهعنوان یک موجودیت کاملاً مستقل در نظر نمیگیریم. ممکن است یک فرد، شرکت، صرافی یا سرویس از تعداد زیادی آدرس استفاده کند. در چنین شرایطی، اگر هر آدرس را بهصورت جداگانه تحلیل کنیم، ممکن است تصویر واقعی فعالیت را از دست بدهیم. اینجاست که مفهوم Address Clustering مطرح میشود. Address Clustering به زبان ساده تلاش میکند آدرسهایی را که احتمال دارد تحت کنترل یک موجودیت واحد باشند، در یک گروه قرار دهد. منابع تخصصی Blockchain Analytics نیز آن را یکی از تکنیکهای پایه در تحلیل تراکنشها و تحقیقات بلاکچینی میدانند. اما یک نکته بسیار مهم وجود دارد: Cluster با هویت واقعی یک شخص یکسان نیست. و همین موضوع، بخش مهم تحلیل امروز ماست.
Address Clustering چیست؟
فرض کنید پنج آدرس مختلف داریم:
A – B – C – D – E
تحلیل تراکنشها نشان میدهد این آدرسها در الگوهای خاصی با یکدیگر ارتباط دارند.
تحلیلگر ممکن است فرض کند:
A + B + C + D + E → احتمالاً یک کنترلکننده مشترک
این مجموعه را میتوان یک Cluster در نظر گرفت.
اما Cluster الزاماً نمیگوید:
«این پنج آدرس متعلق به شخص X هستند.»
بلکه در سطحی پایینتر میگوید:
«شواهد موجود احتمال ارتباط این آدرسها با یک واحد کنترلی مشترک را مطرح میکند.»
چرا Clustering اهمیت دارد؟
تصور کنید یک صرافی ۵۰۰ هزار آدرس داشته باشد.
اگر تحلیلگر هر آدرس را یک موجودیت مستقل بداند، تصویر بسیار گمراهکنندهای ایجاد میشود.
ممکن است در واقع تمام آن آدرسها بخشی از زیرساخت یک سرویس واحد باشند.
در مقابل، یک فرد نیز ممکن است چندین آدرس داشته باشد.
بنابراین:
تعداد آدرسها ≠ تعداد کاربران
Clustering چگونه انجام میشود؟
روش دقیق به شبکه و نوع داده بستگی دارد.
در برخی بلاکچینها، الگوهایی مانند:
- Common Input
- رفتار زمانی
- الگوی تأمین Gas
- آدرسهای Deposit
- ساختار تراکنش
- ارتباطات تکرارشونده
میتوانند برای ایجاد فرضیههای خوشهبندی مورد استفاده قرار گیرند.
اما قدرت هر روش متفاوت است.
یک مثال ساده
فرض کنید در یک سیستم:
A + B → C
و در چند تراکنش دیگر نیز الگوهای مرتبطی مشاهده میشود.
این موضوع ممکن است یک سرنخ ایجاد کند.
اما یک تحلیلگر حرفهای نباید صرفاً با مشاهده یک رابطه بگوید:
«A و B قطعاً متعلق به یک فرد هستند.»
بلکه باید بپرسد:
- این الگو چند بار تکرار شده؟
- آیا استثنا وجود دارد؟
- ساختار شبکه چیست؟
- آیا سرویس واسط وجود دارد؟
- آیا شواهد مستقل دیگری نیز وجود دارد؟
تفاوت Clustering و Attribution
این دو مفهوم بسیار مهماند.
Clustering
میپرسد:
«کدام آدرسها ممکن است با یکدیگر ارتباط کنترلی داشته باشند؟»
Attribution
میپرسد:
«این آدرس یا Cluster به چه شخص، سازمان یا سرویس واقعی مرتبط است؟»
مثلاً:
A + B + C → Cluster
و سپس اطلاعات معتبر خارج از زنجیره نشان میدهد:
Cluster → Exchange X
این مرحله دوم Attribution است.
چرا نباید این دو را یکی بدانیم؟
فرض کنید یک تحلیلگر متوجه شود سه آدرس احتمالاً تحت کنترل یک موجودیت واحد هستند.
این یافته مهم است.
اما هنوز مشخص نیست آن موجودیت:
- یک فرد است،
- یک شرکت است،
- یک صرافی است،
- یک ربات است،
- یا یک سرویس دیگر.
بنابراین Clustering فقط یک بخش از پازل است.
تحقیقات جدید چه چیزی را نشان میدهند؟
موضوع دقت Clustering در سال ۲۰۲۶ نیز مورد بحث جدی پژوهشی است.
یک پژوهش منتشرشده در سال ۲۰۲۶ درباره Multi-Input Heuristic در Bitcoin بهطور مشخص قابلیت اطمینان این روش را در زمینههای مرتبط با تحقیقات قانونی بررسی میکند.
از سوی دیگر، برخی تحلیلهای تخصصی نیز تأکید میکنند که نتیجه Address Clustering بهتر است بهعنوان سرنخ تحلیلی در نظر گرفته شود، نه اینکه بدون بررسیهای بیشتر بهعنوان اثبات قطعی هویت ارائه شود.
این تفاوت برای گزارشهای حرفهای بسیار مهم است.
یک سناریوی تحلیلی
فرض کنید یک پرونده شامل چهار آدرس است:
A
B
C
D
تحلیلگر متوجه میشود:
- A و B الگوهای مشترکی دارند.
- B و C در چند تراکنش نزدیک به هم فعالیت کردهاند.
- C و D منابع تأمین مشابهی دارند.
نتیجه اولیه:
احتمال وجود ارتباط میان این آدرسها وجود دارد.
اما نتیجه نهایی نباید فوراً این باشد:
«هر چهار آدرس متعلق به متهم هستند.»
برای چنین نتیجهای باید شواهد مستقل بیشتری وجود داشته باشد.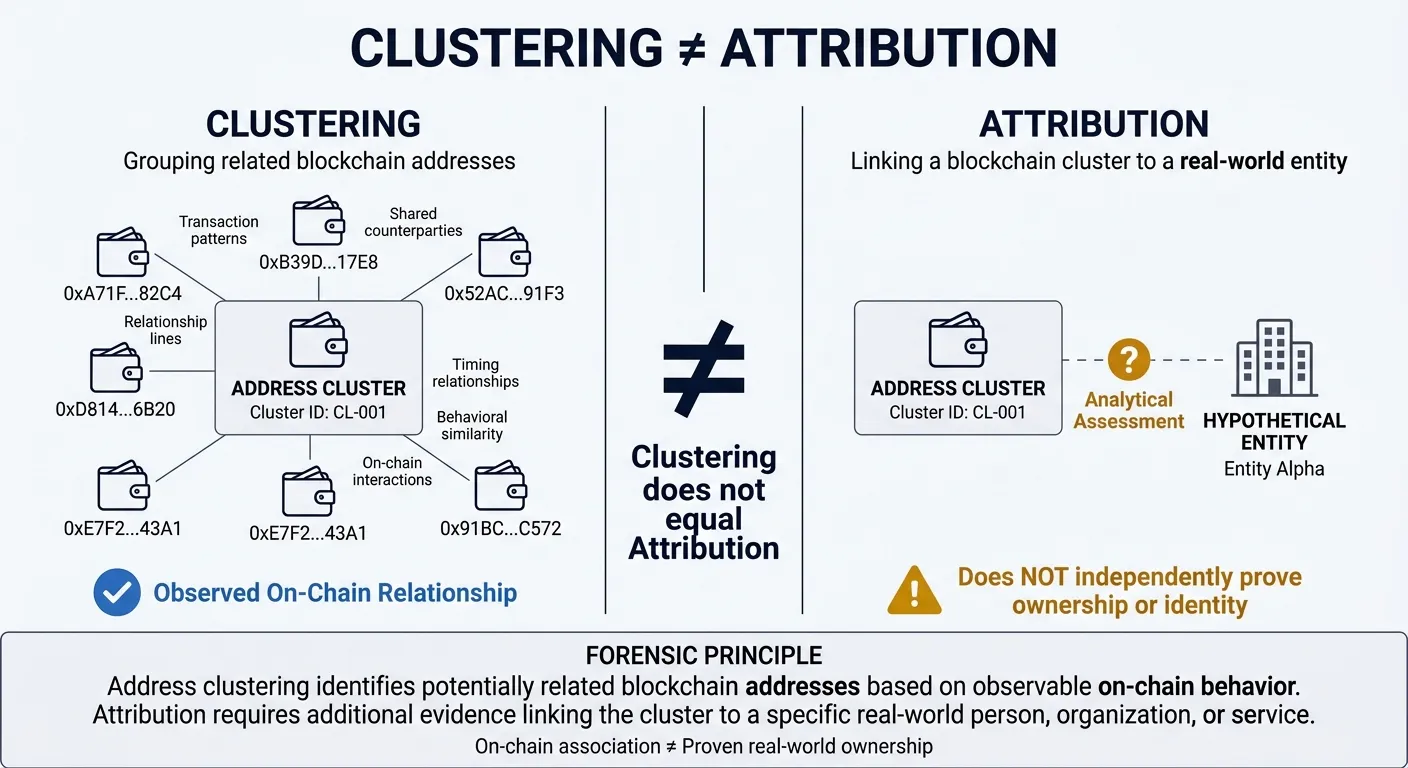
مشکل False Positive
اگر Clustering بیش از حد گسترده انجام شود، ممکن است دو مجموعه مستقل به اشتباه در یک گروه قرار گیرند.
این مسئله False Positive ایجاد میکند.
در پروندههای حساس، چنین خطایی میتواند مسیر تحقیقات را منحرف کند.
به همین دلیل، هر Heuristic باید با Context و شواهد مستقل بررسی شود.
چرا صرافیها یک چالش مهم هستند؟
صرافیها معمولاً تعداد بسیار زیادی آدرس برای دریافت و مدیریت دارایی دارند.
ممکن است یک کاربر تصور کند:
A → B
و B یک کیف پول شخصی است.
در حالی که B میتواند بخشی از زیرساخت یک سرویس باشد.
بنابراین تحلیلگر باید از Labelهای معتبر و سایر شواهد استفاده کند.
Cluster Size چه چیزی به ما میگوید؟
فرض کنید یک Cluster شامل:
۳ آدرس
باشد.
با Cluster دیگری مواجه میشویم که:
۵۰۰۰ آدرس
دارد.
این دو ساختار از نظر تحلیلی یکسان نیستند.
یک Cluster بزرگ ممکن است مربوط به یک سرویس باشد، در حالی که یک Cluster کوچک ممکن است یک کاربر یا مجموعه محدود آدرسها را نشان دهد.
اما باز هم اندازه Cluster بهتنهایی مالکیت را ثابت نمیکند.
ترکیب چند منبع شواهد
برای تحلیل قویتر بهتر است Clustering با اطلاعات دیگر ترکیب شود:
On-Chain
رفتار تراکنشها
OSINT
اطلاعات عمومی
Exchange Intelligence
اطلاعات مربوط به سرویسها
Temporal Analysis
تحلیل زمانی
Transaction Graph
تحلیل ساختار شبکه
Chainalysis نیز در توضیح Blockchain Forensics بر ترکیب Address Clustering با Entity Attribution، تحلیل گراف و اطلاعات خارج از زنجیره تأکید میکند.
یک مدل ساده برای ارزیابی
برای گزارش داخلی میتوان از چنین ساختاری استفاده کرد:
یافته
سطح اطمینان
تراکنش مستقیم
بالا
ارتباط تکرارشونده
متوسط تا بالا
Cluster مبتنی بر Heuristic
متوسط
انتساب به سرویس
بسته به منبع
انتساب به فرد
نیازمند شواهد مستقل
این جدول کمک میکند گزارش از نتیجهگیری بیش از حد دور بماند.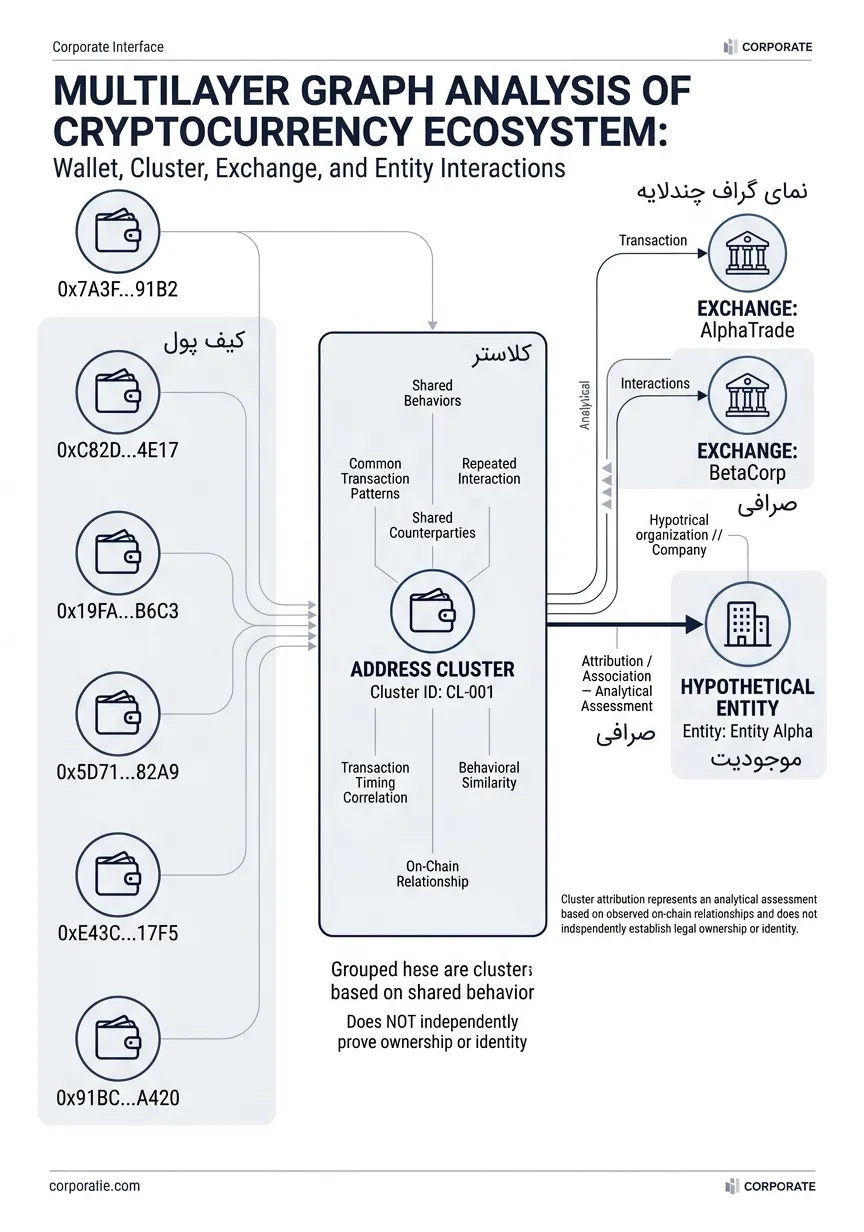
آیا Clustering برای AML کاربرد دارد؟
بله.
در AML، اگر تعداد زیادی آدرس در واقع متعلق به یک موجودیت باشند، بررسی آنها بهصورت جداگانه ممکن است ریسک واقعی را پنهان کند.
Clustering میتواند برای:
- Transaction Monitoring
- Risk Assessment
- Investigation
- Exposure Analysis
- Fund Flow Analysis
مفید باشد.
اما خروجی آن باید با سطح اطمینان مناسب استفاده شود.
مهمترین اشتباه تحلیلی
یکی از خطرناکترین جملات در گزارشهای بلاکچینی این است:
«این آدرسها متعلق به یک شخص هستند.»
در حالی که شواهد فقط نشان دادهاند:
«این آدرسها احتمالاً با یکدیگر مرتبط هستند.»
این دو جمله از نظر کارشناسی فاصله زیادی دارند.
نتیجهگیری
Address Clustering یکی از ابزارهای قدرتمند تحلیل بلاکچین است.
اما قدرت واقعی آن زمانی مشخص میشود که تحلیلگر بداند چه چیزی را اثبات میکند و چه چیزی را اثبات نمیکند.
Cluster میتواند یک سرنخ بسیار ارزشمند باشد.
اما:
Cluster ≠ Identity
و:
Address Relationship ≠ Proof of Ownership
تحلیل حرفهای زمانی شکل میگیرد که Clustering در کنار دادههای آنچین، اطلاعات خارج از زنجیره، تحلیل زمانی و شواهد مستقل قرار گیرد.
بلاگها و مقالات
مشاهده همه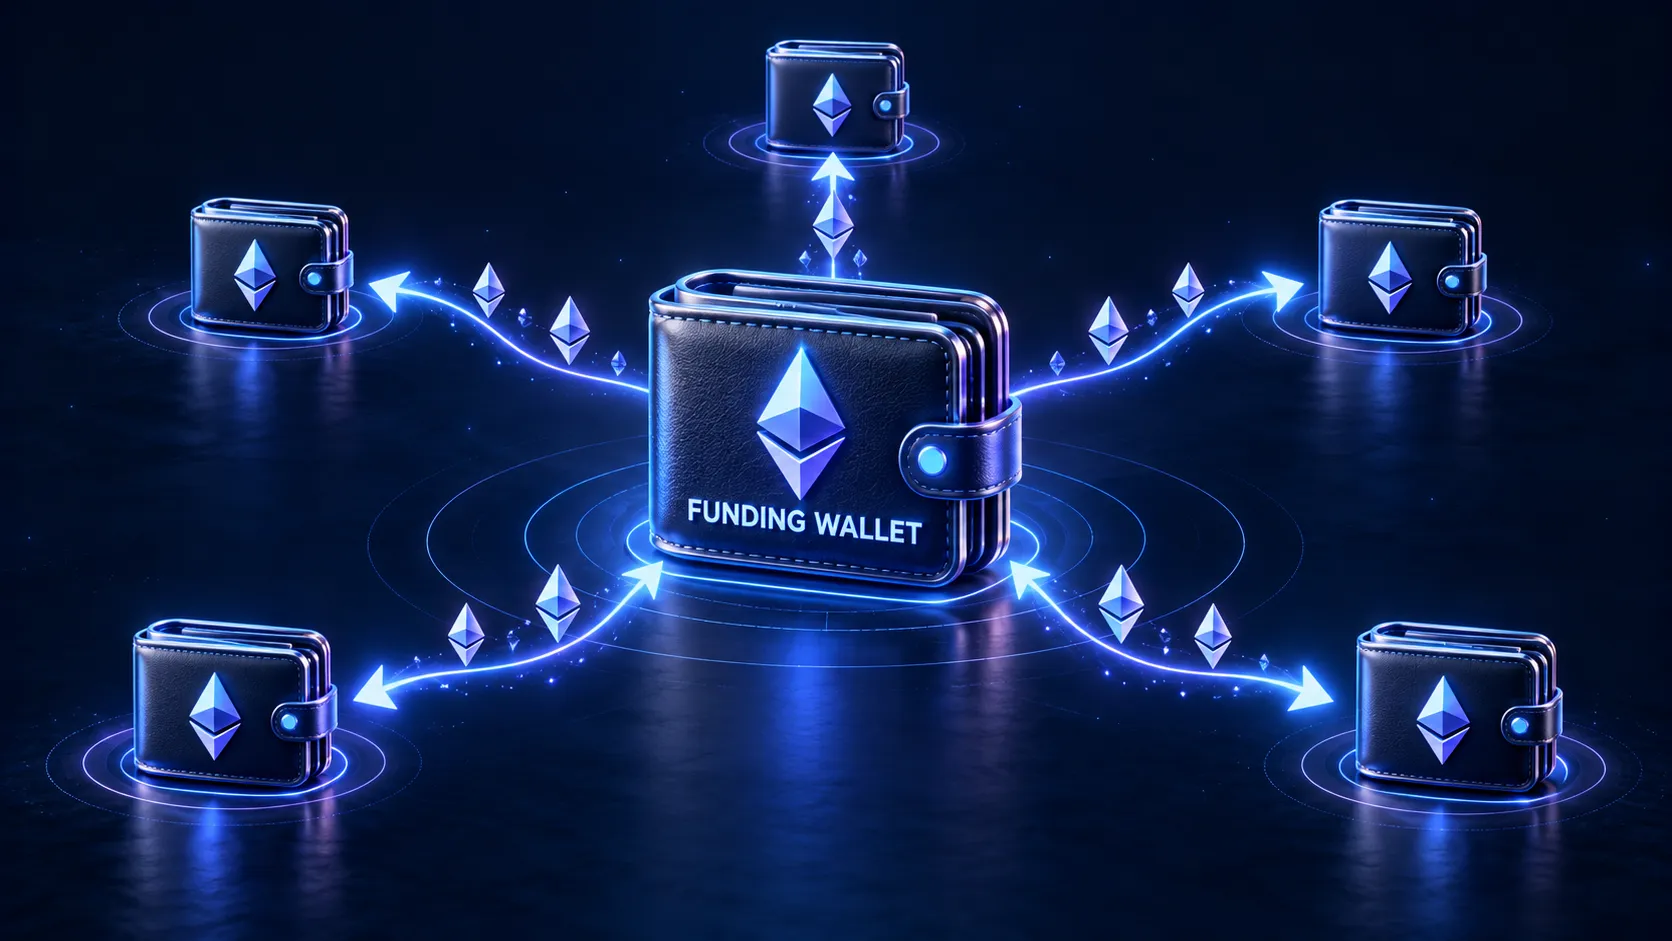
Gas Funding Analysis چیست؟
فرض کنید در یک پرونده کلاهبرداری رمزارزی، دارایی سرقتشده به پنج کیف پول متفاوت منتقل شده است. این کیف پولها ظاهراً ارتباط مستقیمی با یکدیگر ندارند. هرکدام آدرس مستقل، تاریخچه متفاوت و مجموعهای از تراکنشهای جداگانه دارند. اما هنگام بررسی دقیقتر متوجه میشویم که همه آنها پیش از اولین انتقال، مقدار کمی ETH از یک آدرس مشترک دریافت کردهاند. آیا این اتفاق تصادفی است؟ آیا پنج کیف پول توسط یک شخص کنترل میشوند؟ یا آدرس مشترک صرفاً متعلق به یک صرافی یا سرویس تأمین Gas است؟ این پرسشها نقطه آغاز Gas Funding Analysis هستند؛ روشی برای بررسی ارتباطات احتمالی میان آدرسها از طریق تحلیل منابع تأمین کارمزد شبکه.
Chain Hopping چیست؟
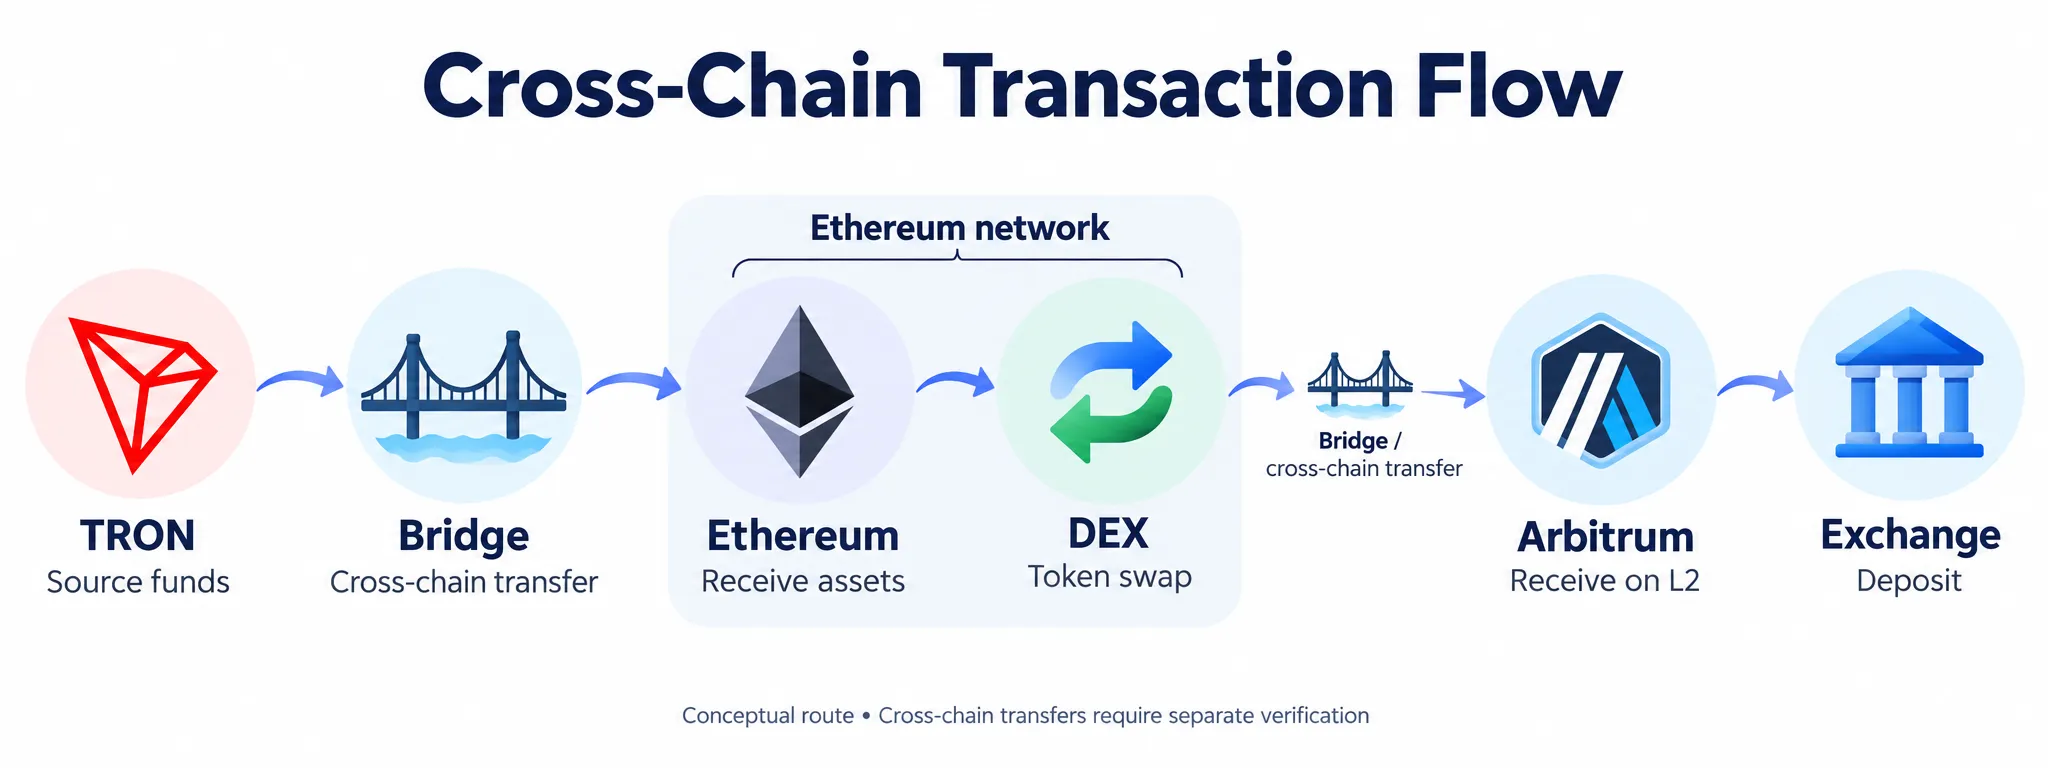
یک تصور قدیمی درباره ردگیری رمزارز وجود دارد: «کافی است دارایی را به شبکه دیگری ببریم تا رد آن گم شود.» اما Blockchain Forensics امروز بسیار فراتر از بررسی یک Explorer واحد رفته است. پژوهشهای ۲۰۲۶ نیز دقیقاً به همین تحول اشاره میکنند. یک مقاله ارائهشده در کنفرانس IEEE ICBC توضیح میدهد که DeFi، Bridgeهای غیرمتمرکز و Chain Hopping، تحقیقات را از یک مسئله محلی روی یک زنجیره به یک مسئله چندزنجیرهای و پیچیده تبدیل کردهاند. Doi مطالعه دیگری در اوت ۲۰۲۶ نیز یک چارچوب Forensic برای ردیابی دارایی در محیطهای چندلایه و میان Layer 1 و Layer 2 پیشنهاد کرده است. MDPI بنابراین Chain Hopping مسیر را سختتر میکند؛ اما سختترشدن با ناپدیدشدن کامل ردپا یکسان نیست.
Wash Trading چیست و چگونه میتوان معاملات ساختگی را روی بلاکچین شناسایی کرد؟
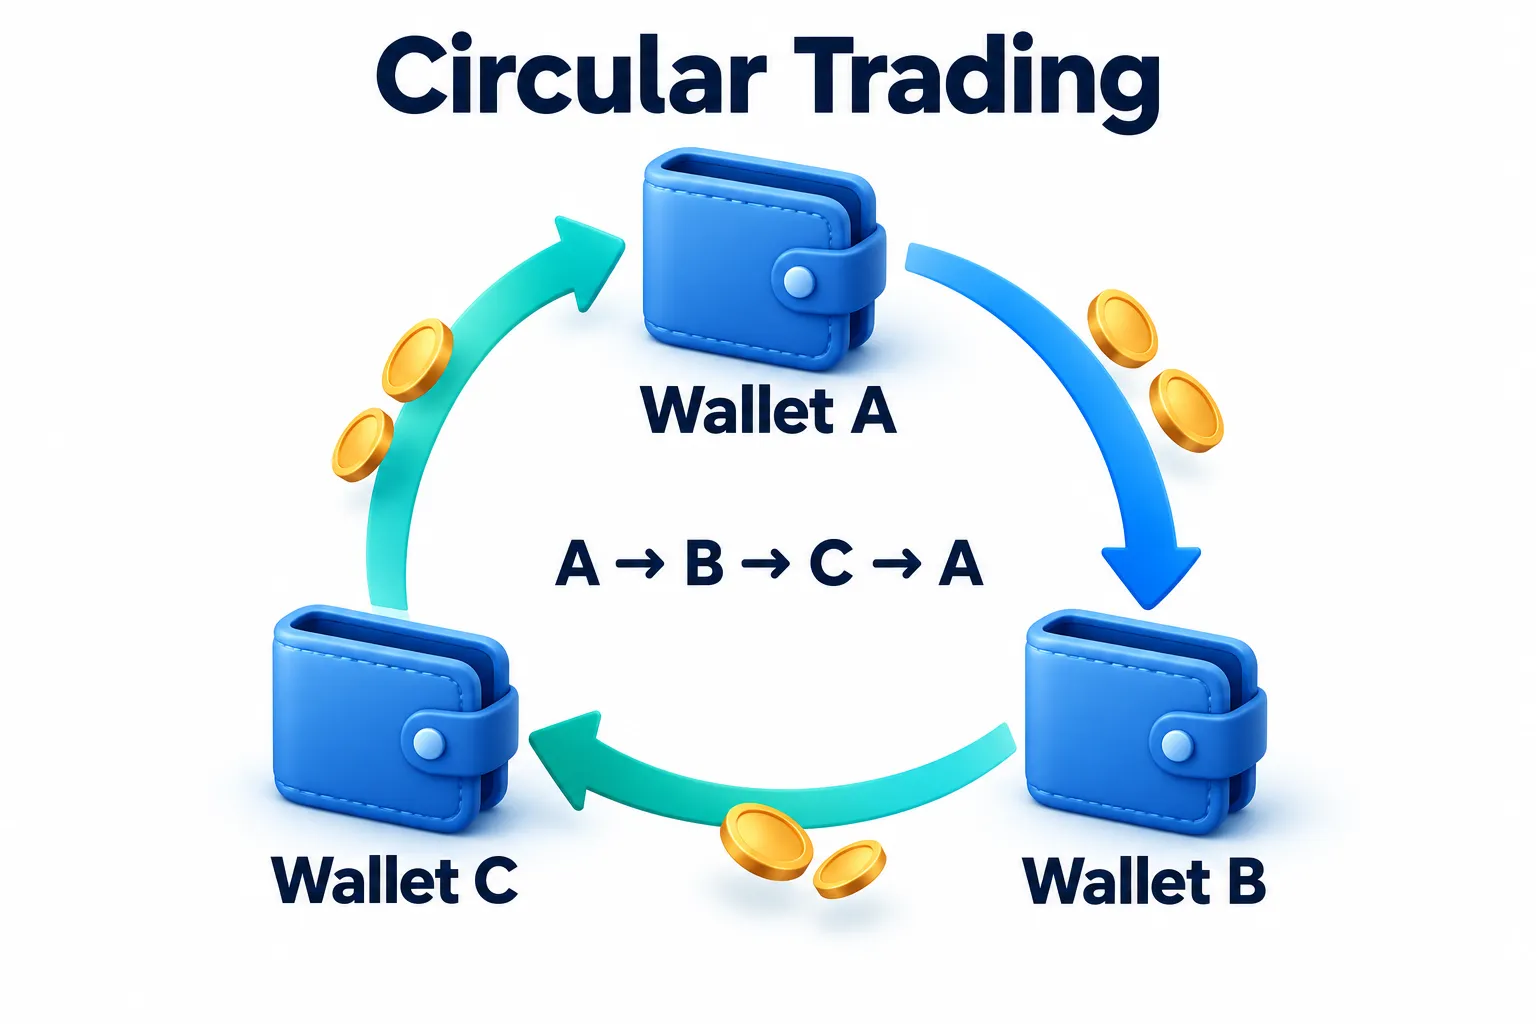
حجم معاملات یکی از اولین اعدادی است که هنگام بررسی یک Token یا بازار دیده میشود. فرض کنید یک Token تازه ایجادشده در مدت کوتاهی: $20,000,000 Trading Volume ثبت کرده باشد. در نگاه اول ممکن است تصور کنیم هزاران معاملهگر در حال خریدوفروش آن هستند. اما اگر بخش قابل توجهی از این معاملات توسط مجموعه کوچکی از Walletهای مرتبط ایجاد شده باشد چه؟ اینجا مفهوم Wash Trading اهمیت پیدا میکند. در یک بررسی منتشرشده در ۲۴ سپتامبر ۲۰۲۶، Bitquery با روش تحلیلی خود معاملات DEX در شش شبکه را بررسی کرد و گزارش داد بخش بزرگی از حجم مورد بررسی، معیارهای آنها برای معاملات غیرواقعی را داشته است. این یافته یک حکم عمومی درباره کل بازار نیست، اما نشان میدهد حجم ثبتشده روی زنجیره را نباید بدون تحلیل ساختار معاملات معادل تقاضای واقعی دانست. Bitquery
چگونه رفتار کیف پول صرافی را از کیف پول شخصی تشخیص دهیم؟
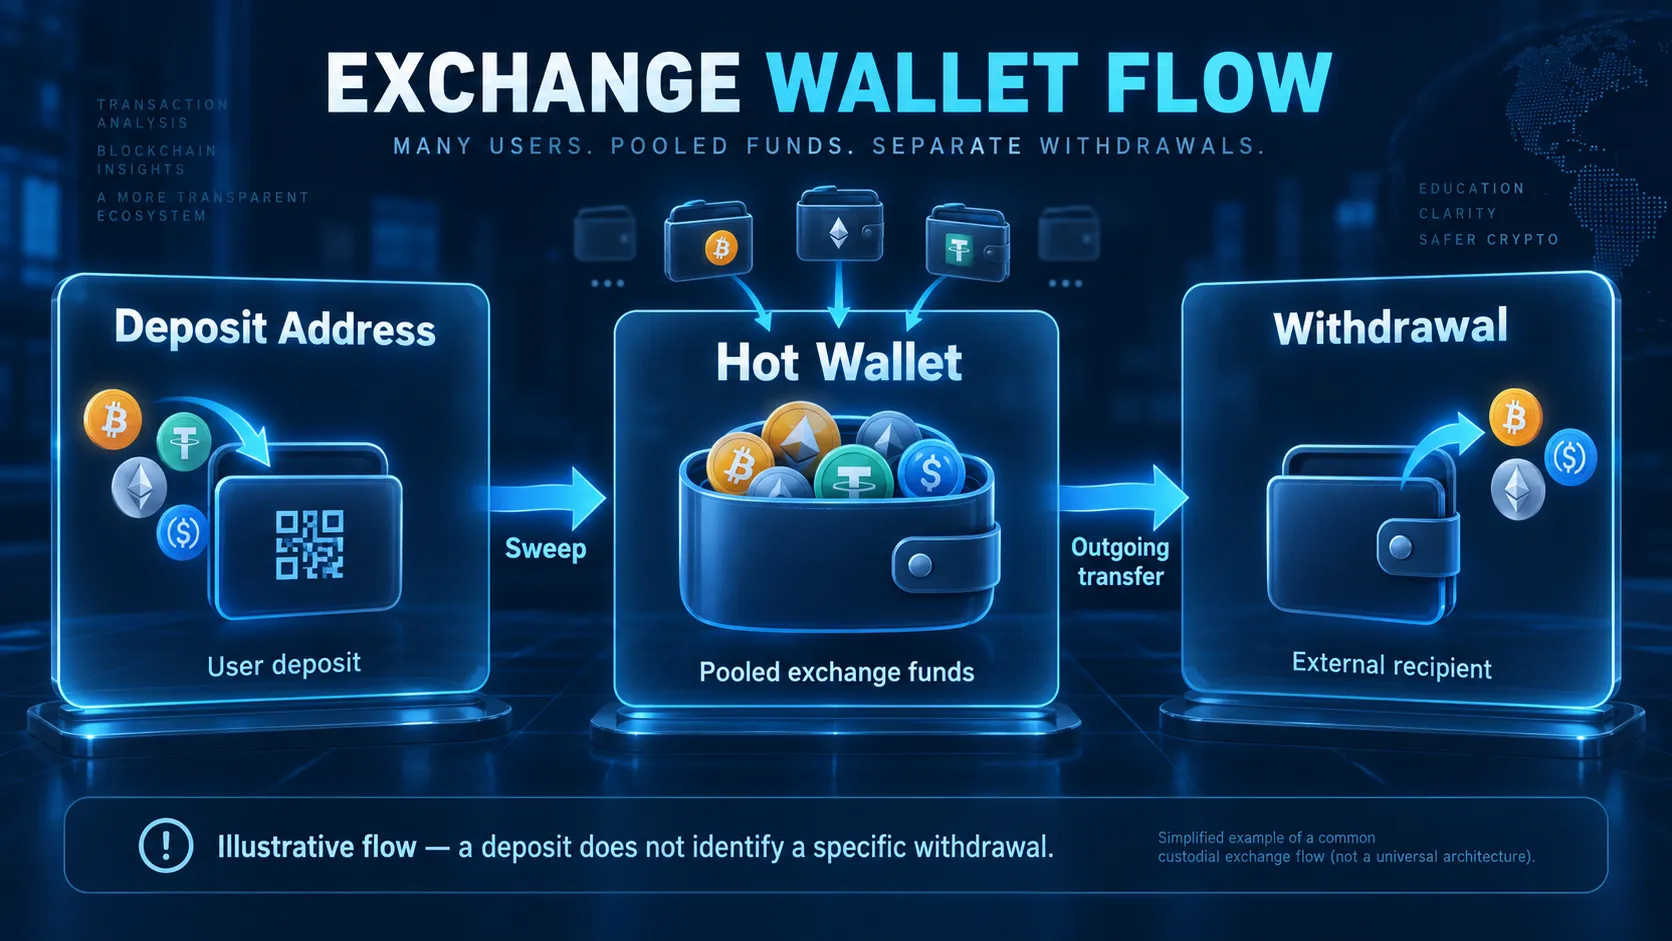
در بسیاری از تحقیقات Blockchain Forensics یک سؤال مهم مطرح میشود: آیا این آدرس متعلق به یک کاربر عادی است یا بخشی از زیرساخت یک صرافی؟ این سؤال ساده به نظر میرسد، اما پاسخ همیشه ساده نیست. یک صرافی ممکن است هزاران یا حتی میلیونها Deposit Address داشته باشد و ساختار مدیریت وجوه آن با یک Wallet شخصی تفاوت زیادی داشته باشد. از طرف دیگر، صرفاً داشتن تعداد زیاد تراکنش نیز ثابت نمیکند یک آدرس متعلق به Exchange است. برای تحلیل صحیح باید رفتار آدرس بررسی شود.
